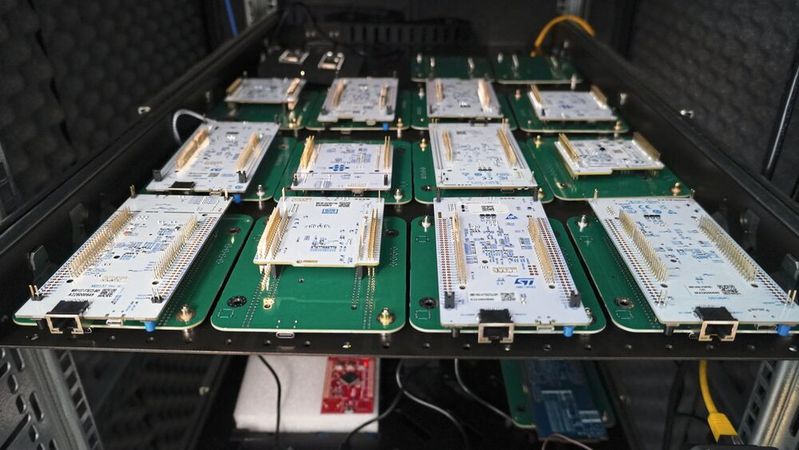
Ausführliche Hardware-in-the-Loop-Tests sind eine der besten Methoden, um zuverlässige Firmware zu entwickeln. In der Praxis gestalten sich klassische HIL-Setups für viele Entwicklungsteams als zu teuer, schwer skalierbar und wartungsintensiv. Genau dies sind aber Bereiche, in denen Cloud-Infrastrukturen leicht sind. Was braucht es, um HIL-Tests vom Labortisch in die Cloud verlagern?
Lässt sich ein Hardware-in-the-Loop-Testsystem in die Cloud verlagern? Das Münchner Startup OnMCU hat das getan, und dabei wertvolle Best-Practice-Erfahrungen gesammelt.
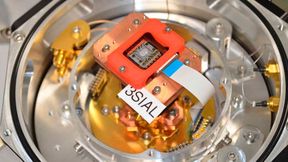
(Bild: OnMCU)
Klassische HIL-Aufbauten sind teuer, schwer zu skalieren und wartungsintensiv. Damit stehen sie im deutlichen Gegensatz zu modernen Cloud- und CI/CD-Infrastrukturen. Ein möglicher Ausweg: Nicht die Hardware selbst wird virtualisiert, sondern der Zugriff darauf. Erfahrungen aus dem Aufbau einer Cloud-HIL-Plattform zeigen, wie sich reale Mikrocontroller-Hardware automatisiert, sicher und ortsunabhängig in Entwicklungsprozesse integrieren lässt und welche Architekturentscheidungen sich dabei bewährt haben.
Beim Entwickeln eingebetteter Systeme führt kein Weg am Testen vorbei. Embedded-Software arbeitet mit begrenzten Ressourcen, steuert Hardware in Echtzeit und kommt häufig dort zum Einsatz, wo Fehler besonders schwerwiegende Folgen haben können: in Fahrzeugen, medizinischen Geräten oder Industrieanlagen. Ein Softwarefehler kann dort nicht nur hohe Kosten verursachen, sondern im schlimmsten Fall Menschen gefährden.
Gleichzeitig hinken die Testprozesse in vielen Embedded-Projekten den Methoden der klassischen Softwareentwicklung hinterher. Genau hier setzt das Konzept cloudbasierter Hardware-in-the-Loop-Tests an. Das Münchner Startup OnMCU hat eine ebensolche Cloud-Plattform für automatisierte Firmwaretests entwickelt. Die hierbei gewonnenen Erfahrungen zeigen, wie sich physische Testhardware so bereitstellen lässt, dass sie ähnlich flexibel genutzt werden kann wie andere Ressourcen einer modernen Software-Infrastruktur.
Warum Embedded-Entwicklung beim Testen noch immer ausgebremst wird
Zwischen klassischer Softwareentwicklung und Embedded-Entwicklung bestehen bei den Testzyklen erhebliche Unterschiede. In der Web- und Cloud-Entwicklung durchläuft ein Commit häufig innerhalb weniger Minuten automatisierte Build- und Testpipelines. Entwickler erhalten schnell Feedback und können Fehler früh korrigieren.
Im Embedded-Bereich sind solche kurzen Feedbackzyklen wesentlich schwieriger umzusetzen. Ein wesentlicher Grund dafür sind Hardware-in-the-Loop-Tests. Dabei wird die zu testende Firmware mit realer oder simulierter Hardware gekoppelt, um ihr Verhalten unter möglichst realistischen Bedingungen zu überprüfen. Für viele Anwendungen, insbesondere im sicherheitskritischen Umfeld, sind solche Tests unverzichtbar.
Die Stärke des Verfahrens ist zugleich seine größte Herausforderung: HIL-Tests benötigen physische Testaufbauten. Ein typisches Setup besteht beispielsweise aus einem bestimmten Entwicklungsboard, einer definierten Verdrahtung, angeschlossener Peripherie sowie zusätzlicher Mess- oder Steuerungstechnik. Diese Umgebung lässt sich nicht beliebig vervielfältigen.
In der Praxis führt das schnell zu Engpässen. Ein Entwickler nutzt den Testplatz, während andere warten. Hardware muss umgebaut oder neu verkabelt werden. Parallele Testläufe sind nur eingeschränkt möglich. Die Integration in CI/CD-Systeme wird aufwendig. Soll die Testkapazität wachsen, steigt auch der physische Aufwand: zusätzliche Boards, mehr Verkabelung, mehr Platz und mehr Wartung. Für Entwicklungsteams, die auf kurze Iterationszyklen und kontinuierliches Feedback angewiesen sind, wird die Testinfrastruktur damit schnell zum Flaschenhals.
Die Hardware bleibt physisch, der Zugriff wird flexibel
Ein naheliegender Ansatz besteht darin, Prinzipien moderner Cloud-Infrastrukturen auf Hardwaretests zu übertragen. Dabei ist allerdings eine wichtige Unterscheidung notwendig. Bei klassischen Cloud-Diensten wie virtuellen Maschinen oder Containern ist die konkrete Hardware für den Anwender meist unerheblich. Rechenleistung wird abstrahiert und kann weitgehend austauschbar bereitgestellt werden.
Bei Hardware-in-the-Loop-Tests funktioniert dieses Prinzip nicht. Hier ist gerade die konkrete physische Umgebung entscheidend: das verwendete Board, die Verdrahtung, angeschlossene Sensorik oder Aktorik, elektrische Eigenschaften und nicht zuletzt das zeitliche Verhalten.
Stand: 08.12.2025
Es ist für uns eine Selbstverständlichkeit, dass wir verantwortungsvoll mit Ihren personenbezogenen Daten umgehen. Sofern wir personenbezogene Daten von Ihnen erheben, verarbeiten wir diese unter Beachtung der geltenden Datenschutzvorschriften. Detaillierte Informationen finden Sie in unserer Datenschutzerklärung.
Einwilligung in die Verwendung von Daten zu Werbezwecken
Ich bin damit einverstanden, dass die Vogel Communications Group GmbH & Co. KG, Max-Planckstr. 7-9, 97082 Würzburg einschließlich aller mit ihr im Sinne der §§ 15 ff. AktG verbundenen Unternehmen (im weiteren: Vogel Communications Group) meine E-Mail-Adresse für die Zusendung von redaktionellen Newslettern nutzt. Auflistungen der jeweils zugehörigen Unternehmen können hier abgerufen werden.
Der Newsletterinhalt erstreckt sich dabei auf Produkte und Dienstleistungen aller zuvor genannten Unternehmen, darunter beispielsweise Fachzeitschriften und Fachbücher, Veranstaltungen und Messen sowie veranstaltungsbezogene Produkte und Dienstleistungen, Print- und Digital-Mediaangebote und Services wie weitere (redaktionelle) Newsletter, Gewinnspiele, Lead-Kampagnen, Marktforschung im Online- und Offline-Bereich, fachspezifische Webportale und E-Learning-Angebote. Wenn auch meine persönliche Telefonnummer erhoben wurde, darf diese für die Unterbreitung von Angeboten der vorgenannten Produkte und Dienstleistungen der vorgenannten Unternehmen und Marktforschung genutzt werden.
Meine Einwilligung umfasst zudem die Verarbeitung meiner E-Mail-Adresse und Telefonnummer für den Datenabgleich zu Marketingzwecken mit ausgewählten Werbepartnern wie z.B. LinkedIN, Google und Meta. Hierfür darf die Vogel Communications Group die genannten Daten gehasht an Werbepartner übermitteln, die diese Daten dann nutzen, um feststellen zu können, ob ich ebenfalls Mitglied auf den besagten Werbepartnerportalen bin. Die Vogel Communications Group nutzt diese Funktion zu Zwecken des Retargeting (Upselling, Crossselling und Kundenbindung), der Generierung von sog. Lookalike Audiences zur Neukundengewinnung und als Ausschlussgrundlage für laufende Werbekampagnen. Weitere Informationen kann ich dem Abschnitt „Datenabgleich zu Marketingzwecken“ in der Datenschutzerklärung entnehmen.
Falls ich im Internet auf Portalen der Vogel Communications Group einschließlich deren mit ihr im Sinne der §§ 15 ff. AktG verbundenen Unternehmen geschützte Inhalte abrufe, muss ich mich mit weiteren Daten für den Zugang zu diesen Inhalten registrieren. Im Gegenzug für diesen gebührenlosen Zugang zu redaktionellen Inhalten dürfen meine Daten im Sinne dieser Einwilligung für die hier genannten Zwecke verwendet werden. Dies gilt nicht für den Datenabgleich zu Marketingzwecken.
Recht auf Widerruf
Mir ist bewusst, dass ich diese Einwilligung jederzeit für die Zukunft widerrufen kann. Durch meinen Widerruf wird die Rechtmäßigkeit der aufgrund meiner Einwilligung bis zum Widerruf erfolgten Verarbeitung nicht berührt. Um meinen Widerruf zu erklären, kann ich als eine Möglichkeit das unter https://contact.vogel.de abrufbare Kontaktformular nutzen. Sofern ich einzelne von mir abonnierte Newsletter nicht mehr erhalten möchte, kann ich darüber hinaus auch den am Ende eines Newsletters eingebundenen Abmeldelink anklicken. Weitere Informationen zu meinem Widerrufsrecht und dessen Ausübung sowie zu den Folgen meines Widerrufs finde ich in der Datenschutzerklärung, Abschnitt Redaktionelle Newsletter.
Cloud-HIL virtualisiert deshalb nicht die Hardware selbst. Virtualisiert wird der Zugriff auf die Hardware.
Die reale Embedded-Hardware bleibt bestehen, wird aber über eine Softwareschicht aus der Ferne erreichbar und steuerbar. Testsysteme lassen sich reservieren, automatisiert konfigurieren und nach einem Testlauf wieder freigeben. Das Ziel ist nicht, einen Mikrocontroller in eine beliebig austauschbare Cloud-Ressource zu verwandeln. Stattdessen wird eine konkrete physische Testinfrastruktur so zugänglich gemacht, wie Softwareteams heute Build-Server oder CI-Runner verwenden.
Entwickler oder CI-Pipelines können Tests remote starten. Die benötigte Hardware wird automatisch zugeordnet. Nach Abschluss steht sie für den nächsten Test zur Verfügung. Dadurch können mehrere Entwickler oder Teams dieselben Testaufbauten wesentlich effizienter nutzen.
Für die Zugriffskontrolle sind dabei unterschiedliche Sicherheitsmechanismen erforderlich. Authentifizierung, Berechtigungsmodelle und konsequente Verschlüsselung müssen sicherstellen, dass Testumgebungen voneinander getrennt bleiben und nur autorisierte Nutzer auf die jeweilige Hardware zugreifen können.
Der praktische Nutzen ist erheblich:
HIL-Testsysteme lassen sich ortsunabhängig verwenden.
Vorhandene Hardware kann effizienter ausgelastet werden.
Tests können direkt aus CI/CD-Pipelines gestartet werden.
Manuelle Testphasen am Ende eines Entwicklungszyklus lassen sich durch kontinuierliche Tests ersetzen.
Entwickler erhalten deutlich früher Rückmeldung über das Verhalten ihrer Firmware auf echter Hardware.
Die physischen Tests verschwinden damit nicht. Sie werden vielmehr in die Arbeitsweise moderner Softwareentwicklung integriert.
Einzelne Unternehmen bauen solche Remote-HIL-Lösungen bereits projektspezifisch selbst auf. Dabei wird jedoch leicht unterschätzt, dass nicht nur die Entwicklung, sondern insbesondere Betrieb, Wartung, Zugriffskontrolle und Skalierung erheblichen Aufwand verursachen.
Erkenntnisse aus dem Aufbau einer Cloud-HIL-Plattform
Eine der wichtigsten Erkenntnisse beim Aufbau verteilter Testinfrastrukturen lautet: Komplexität konsequent begrenzen. Ein Cloud-HIL-System ist zwangsläufig über mehrere technische und häufig auch räumliche Ebenen verteilt. Hardware, Edge-Systeme, Backend-Dienste, Datenbank, Benutzeroberflächen und CI-Integrationen müssen zuverlässig zusammenspielen. Zusätzliche Komplexität sollte deshalb nur dort entstehen, wo sie einen klaren technischen Nutzen bringt.
Aus dem Aufbau der OnMCU-Plattform lassen sich mehrere Prinzipien ableiten, die auch für andere verteilte Entwicklungs- und Testsysteme relevant sind:
Standardhardware statt eigener Entwicklungsboards. Wo immer möglich, empfiehlt sich der Einsatz etablierter Standard-Entwicklungsboards. Eigene MCU-Boards können zwar exakt auf einen Anwendungsfall zugeschnitten werden, erzeugen jedoch zusätzliche Entwicklungs-, Produktions- und Wartungsaufwände. Standardhardware reduziert diese Abhängigkeiten und erleichtert außerdem den Austausch einzelner Komponenten. Gerade beim Aufbau einer neuen Plattform ist diese Reduktion der Varianten ein wichtiger Faktor.
Klare Aufgabenverteilung zwischen Controller und Edge. Eine bewährte Architektur besteht darin, das Gesamtsystem in mehrere klar abgegrenzte Programme aufzuteilen. Ein zentraler Controller koordiniert die Aufgaben und stellt die externen APIs bereit. Die eigentlichen Entwicklungsboards sind über Edge-Server angebunden. Dabei sollte der Edge-Server möglichst wenig eigene Logik enthalten. Seine Aufgabe besteht vor allem darin, Anweisungen des Controllers auszuführen und das Ergebnis zurückzumelden. Entscheidungen über Scheduling, Fehlerbehandlung oder Wiederanlauf verbleiben dagegen beim Controller. Dieses Prinzip vereinfacht den Betrieb erheblich. Je weniger Entscheidungen ein verteilter Edge-Knoten selbst treffen muss, desto geringer wird das Risiko unterschiedlicher Zustände und schwer reproduzierbarer Fehler.
Ergänzend können getrennte Benutzeroberflächen sinnvoll sein: eine Oberfläche für Entwickler und Nutzer der Plattform sowie eine administrative Oberfläche zur Verwaltung von Boards und Infrastruktur.Für lokale Entwicklungsumgebungen und CI-Pipelines bietet sich zusätzlich ein Kommandozeilentool an. Bei OnMCU steht dafür ein Open-Source-CLI zur Verfügung, über das sich Tests sowohl vom Entwicklungsrechner als auch aus Automatisierungssystemen starten lassen.
Möglichst lange beim Monorepo bleiben. Bei verteilten Systemen liegt es nahe, einzelne Komponenten frühzeitig in eigene Repositories aufzuteilen. Das schafft jedoch neue Abhängigkeiten: Versionen müssen synchronisiert, Schnittstellen abgestimmt und Änderungen über mehrere Repositories hinweg koordiniert werden.
Solange ein Projekt überschaubar bleibt, kann deshalb ein Monorepo erhebliche Vorteile bieten. Gemeinsame Änderungen lassen sich atomar umsetzen, Schnittstellen entwickeln sich nicht unbemerkt auseinander und automatisierte Prüfungen können das Gesamtsystem berücksichtigen. Eine Auslagerung lohnt sich vor allem dort, wo ein klarer Grund besteht, etwa bei eigenständig veröffentlichten Open-Source-Komponenten.
Möglichst wenig Zustand im Scheduler halten. Eine weitere wichtige Architekturentscheidung betrifft den internen Zustand des Systems. Controller und Scheduler sollten möglichst wenige Informationen ausschließlich im Arbeitsspeicher halten. Wo immer möglich, sollte sich der aktuelle Zustand aus persistenten Daten und Statusmeldungen rekonstruieren lassen. Das erleichtert Neustarts und Fehlerbehandlung erheblich.
Ein Crash des Controllers sollte im Idealfall lediglich aktuell laufende Jobs betreffen. Das Gesamtsystem muss anschließend aus der Datenbank und den Rückmeldungen der angeschlossenen Komponenten wieder einen konsistenten Zustand herstellen können. Je weniger impliziter Zustand vorhanden ist, desto robuster wird das System.
Datenbankzugriffe zentralisieren. Auch beim Datenbankzugriff hilft eine klare Grenze. Statt mehreren Komponenten direkten Zugriff auf die Datenbank zu geben, sollte möglichst nur ein zentraler Dienst Daten lesen und verändern. Webinterfaces, administrative Werkzeuge und externe Clients greifen ausschließlich über definierte APIs darauf zu. Das verhindert versteckte Abhängigkeiten zwischen Anwendungen und Datenbankschema.
Noch wichtiger wird dieses Prinzip beim Berechtigungsmanagement. Eine zentrale API schafft einen kontrollierbaren Zugangspunkt, an dem Authentifizierung, Autorisierung, Validierung und Protokollierung einheitlich umgesetzt werden können.
Schnittstellen brauchen eine Single Source of Truth. Verteilte Systeme scheitern häufig nicht an einzelnen Komponenten, sondern an unterschiedlichen Interpretationen derselben Schnittstelle. Deshalb sollte für jedes Protokoll möglichst eine eindeutige Quelle existieren.
Bei der Kommunikation über NATS kann das beispielsweise bedeuten, dass das Wire-Format in einer gemeinsam verwendeten Bibliothek definiert wird. Änderungen müssen dann nicht mehrfach und potenziell unterschiedlich implementiert werden.
Dasselbe Prinzip lässt sich auf REST-Schnittstellen übertragen. Bei OnMCU erzeugt der REST-API-Server beispielsweise automatisch eine OpenAPI-Spezifikation aus dem Rust-Code. Die benötigten API-Clients können anschließend aus dieser Spezifikation generiert werden, für Rust etwa mit „progenitor“, für TypeScript mit „orval“. Dadurch sinkt das Risiko, dass Server und Client unterschiedliche Vorstellungen derselben Schnittstelle entwickeln.
Munich Embedded 2026
Die Munich Embedded 2026 (ME26) bringt Entwickler aus der Embedded-Branche zusammen, um die drängendsten Herausforderungen der Branche zu diskutieren:
Wie können wir die Qualität und Sicherheit von Embedded-Systemen gewährleisten?
Welche Tools und Methoden unterstützen uns dabei am besten?
Wie wird die Embedded-Entwicklung der Zukunft aussehen?
In fokussierten Vorträgen und kurzen Lightning Talks teilen Experten ihre Erfahrungen zu Testing-Strategien, Security-Konzepten und Entwicklungswerkzeugen. Die Munich Embedded schafft dabei den idealen Rahmen für intensiven Austausch, konkret und praxisnah.
Die Munich Embedded 2026 findet am 27. Oktober 2026 statt. Näheres unter www.munich-embedded.com.
Beim Technologie-Stack zählt nicht maximale Modernität
Auch bei der Wahl des Technologie-Stacks zahlt sich Zurückhaltung aus. Neue Technologien sind nicht automatisch besser geeignet. Sehr junge Werkzeuge bringen häufig noch instabile Schnittstellen, kleinere Communities oder unvollständige Toolchains mit sich. Umgekehrt können überholte oder unnötig komplexe Technologien langfristig ebenfalls zum Problem werden.
Gefragt ist deshalb ein Mittelweg: Technologien sollten etabliert genug für einen zuverlässigen Betrieb sein, aber gleichzeitig moderne Entwicklungsprozesse unterstützen.
Zwei Beispiele aus dem Aufbau der Plattform:
Rust als Programmiersprache. Rust verbindet moderne Sprachkonzepte mit hoher Performance und eignet sich für Webanwendungen, Systems Programming und Embedded-Entwicklung. Damit kann eine gemeinsame Technologiebasis für unterschiedliche Teile eines Systems entstehen.
SQLite als Datenbank. Für junge oder zunächst überschaubare Systeme kann SQLite völlig ausreichend sein. Die Datenbank ist weit verbreitet, performant und benötigt kaum Betriebsaufwand. Im einfachsten Fall besteht das komplette Setup aus einer einzigen Datei. Steigen die Anforderungen später, kann der Wechsel auf eine größere Datenbanklösung erfolgen.
Die übergeordnete Erkenntnis lautet: Infrastruktur sollte nicht vorsorglich für eine Größenordnung gebaut werden, die möglicherweise nie erreicht wird.
CI/CD früh einführen, nicht erst nach dem Wachstum
Automatisierung sollte möglichst früh Teil des Entwicklungsprozesses werden. CI/CD-Systeme wie GitHub Actions verursachen zunächst zusätzlichen Konfigurationsaufwand. Dieser Aufwand amortisiert sich jedoch schnell. Automatisierte Pipelines können beispielsweise:
Formatierungsregeln prüfen,
Code nach jeder Änderung kompilieren,
Unit- und Integrationstests ausführen,
Abhängigkeiten auf bekannte Schwachstellen untersuchen,
Builds reproduzierbar erzeugen.
Prüfungen, die ansonsten manuell oder möglicherweise gar nicht stattfinden würden, werden dadurch fester Bestandteil jedes Commits oder Pull Requests. Das gilt grundsätzlich für nahezu jede Art von Software, von Linux-Anwendungen über Serverdienste bis zu Bare-Metal-Firmware.
In der Embedded-Entwicklung entsteht allerdings eine zusätzliche Herausforderung: Der Code lässt sich in einer gewöhnlichen CI-Umgebung problemlos kompilieren. Das tatsächliche Verhalten kann jedoch häufig nur auf der Zielhardware überprüft werden. Damit benötigt die CI-Pipeline Zugriff auf einen realen Mikrocontroller.
Genau an dieser Stelle setzt eine Cloud-HIL-Infrastruktur an: Sie verbindet die Automatisierung einer klassischen CI/CD-Pipeline mit der für Embedded-Systeme notwendigen physischen Zielhardware. Ein Commit kann dadurch nicht nur einen Build auslösen, sondern anschließend automatisch Firmware flashen, Hardwaretests starten und deren Ergebnisse an die Entwicklungsumgebung zurückmelden. Damit schließt sich eine der größten Lücken zwischen moderner Softwareentwicklung und Embedded-Entwicklung.
Die unterschätzte Herausforderung: Hardware muss auch mechanisch skalieren
Nicht alle Probleme einer Cloud-HIL-Plattform lassen sich mit Software lösen: Eine der praktischen Erkenntnisse aus dem Aufbau der OnMCU-Infrastruktur betrifft einen Bereich, der bei der Architekturplanung leicht übersehen wird: die mechanische Integration der Hardware.
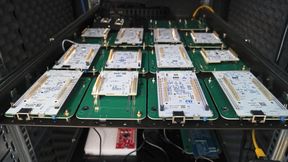
Standard-Serverracks sind für Server, Switches und andere klassische Rechenzentrumskomponenten ausgelegt. Entwicklungsboards, Debugger und individuell verdrahtete Embedded-Hardware passen dagegen nicht ohne Weiteres in dieses Raster. Geeignete Einschubsysteme für Entwicklungsboards fehlen häufig. Auch für Kabelführung, Befestigung oder bewegliche Verbindungen existieren nur selten passende Standardlösungen.
Selbst die Stromversorgung kann Sonderlösungen erforderlich machen. Bei der OnMCU-Infrastruktur wurde beispielsweise für die Edge-Server eine Versorgung über Power over Ethernet realisiert.
Die Erfahrung daraus ist übertragbar: Wer HIL-Infrastruktur skalieren möchte, sollte Mechanik, Verkabelung und Stromversorgung von Beginn an als Teil der Systemarchitektur betrachten. Die klare Erkenntnis: Ein funktionierender Prototyp auf dem Labortisch ist noch keine skalierbare Testplattform.
Ausblick: Messhardware und Debugger als nächste Integrationsstufen
Cloudbasierte HIL-Infrastrukturen bieten über das reine Flashen und Testen von Mikrocontrollern hinaus weiteres Potenzial. Ein nächster Schritt ist die Integration von Messhardware. Ziel sollte dabei sein, Oszilloskope, Netzteile oder andere Messgeräte möglichst einfach aus automatisierten Testabläufen heraus ansteuern zu können, ohne für jedes Gerät umfangreiche Konfigurationen oder individuelle SCPI-Kommandos pflegen zu müssen.
Eine weitere Herausforderung sind Debugger. Viele Hersteller setzen weiterhin auf proprietäre Lösungen und eigene Ansteuerungssoftware. Einheitliche Schnittstellen fehlen häufig. Für herstellerübergreifende Plattformen bedeutet das zusätzlichen Integrationsaufwand. Teilweise müssen Protokolle erst durch Reverse Engineering erschlossen werden.
Langfristig entscheidet deshalb nicht nur die Verfügbarkeit von Hardware darüber, wie gut sich Embedded-Tests automatisieren lassen. Ebenso wichtig sind offene und standardisierte Schnittstellen für Debugger, Messgeräte und Testhardware.
Fazit
Hardware-in-the-Loop-Tests müssen kein Gegenentwurf zu modernen CI/CD-Prozessen sein: Die physische Hardware lässt sich zwar nicht auf dieselbe Weise abstrahieren wie klassische Cloud-Ressourcen. Ihr Zugriff kann jedoch automatisiert, zentral verwaltet und ortsunabhängig bereitgestellt werden.
Damit verändert sich die Rolle des HIL-Testplatzes grundlegend: Aus einer lokal genutzten Laborressource wird ein Bestandteil der Entwicklungsinfrastruktur.
Die wichtigsten Erfahrungen aus dem Aufbau einer solchen Plattform sind dabei weniger spektakulär als grundlegend: Komplexität begrenzen, Verantwortlichkeiten klar trennen, Zustände minimieren, Schnittstellen zentral definieren und Automatisierung früh etablieren. Gerade diese Prinzipien machen den Unterschied zwischen einem funktionierenden Remote-Testaufbau und einer HIL-Infrastruktur, die sich dauerhaft betreiben und skalieren lässt. (sg)
* Julian Dickert, Joël Schulz-Andres und Marie Leonie Meier sind Co-Founder des Münchner Start-Ups OnMCU.