Forscher des MIT haben einen neuartigen Ansatz gefunden, um den Einsatz von KI in safetykritischen Anwendungen verlässlich zu machen. Der „Hard Flow“ Algorithmus soll dabei helfen, dass generative KI-Modelle Ergebnisse von hoher Qualität produzieren, die sich an strenge Requirement-Vorgaben halten, bei denen „gut genug“ nicht ausreichend ist.
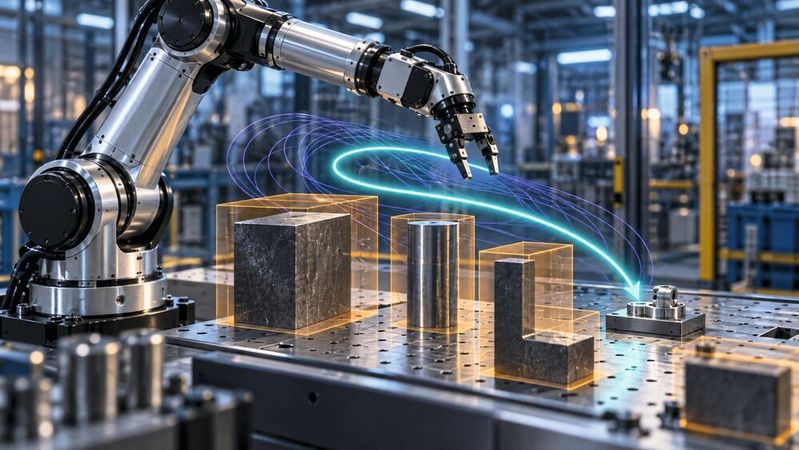
Der am MIT entwickelte Algorithmus „Hard Flow“ verspricht, vortrainierten generativen KI-Modellen dabei zu helfen, strenge Einschränkungen einzuhalten und gleichzeitig die Lösungsqualität zu verbessern, ohne dass ein erneutes Training erforderlich ist.
(Bild: Dall-E / KI-generiert)
Forscher des MIT haben eine neuartige Technik entwickelt, die generativen KI-Modellen dabei hilft, Lösungen für Probleme in einem Hochrisiko-Umfeld zu finden. In solchen Situationen reicht eine plausible Antwort nicht aus: Das Ergebnis muss oft auch unverzichtbare „harte“ sicherheitsrelevante, physikalische oder aufgabenspezifische Anforderungen erfüllen.
Die Forscher entwickelten eine Methode, die generativen Modellen dabei hilft, diese strengen Anforderungen zu erfüllen, ohne dabei Abstriche bei der Qualität ihrer Ergebnisse zu machen. Der Schlüssel zu ihrer Methode liegt darin, dem Modell während des Generierungsprozesses mehr Freiheit zu gewähren und strenge Einschränkungen erst auf das Endergebnis anzuwenden, statt bereits in jedem Zwischenschritt.
In Experimenten aus den Bereichen Robotik, Steuerung physikalischer Prozesse und Computer Vision erfüllte die neue Methode nach Angaben der For scher durchweg die geforderten Einschränkungen und lieferte dabei bessere Lösungen als bestehende Verfahren. Diese anpassungsfähige Plug-and-Play-Technik kommt zum Einsatzzeitpunkt zum Tragen und lässt sich daher auf vortrainierte generative Modelle anwenden, ohne dass diese neu trainiert werden müssen. Sie kann solche Modelle in Anwendungen nützlicher machen, in denen Sicherheitsvorschriften, physikalische Gesetze oder andere strenge Anforderungen nicht verletzt werden dürfen.
„Das Versprechen der generativen KI liegt in ihrer Fähigkeit, einen vielfältigen Raum an Möglichkeiten zu erkunden, doch die reale Welt setzt Grenzen, welche Möglichkeiten akzeptabel sind. Unser Ansatz ermöglicht es uns, diese generative Kraft zu bewahren und gleichzeitig die unverzichtbaren Anforderungen von Anwendungen mit hohem Risiko oder sicherheitskritischen Anwendungen durchzusetzen“, sagt Professor Navid Azizan, leitender Forscher am Labor für Informations- und Entscheidungssysteme (LIDS) des MIT und leitender Autor der begleitenden Studie zu dieser Technik, die in den IEEE Transactions on Pattern Analysis and Machine Intelligence veröffentlicht wurde.
Freiheit zum Entdecken
Vortrainierte generative KI-Modelle, wie beispielsweise Diffusionsmodelle (z. B. Stable Diffusion) und Flow-Matching-Modelle (z. B. FLUX), sind mittlerweile weit verbreitet. Diese leistungsstarken Modelle lernen, durch die Umwandlung von Zufallsrauschen neue Daten zu erzeugen. Dank ihrer Verfügbarkeit können sie für eine Vielzahl von Anwendungen angepasst werden.
Diese leistungsstarken Modelle zeichnen sich dadurch aus, dass sie Antworten liefern, die den meisten Anfragen nahezu gerecht werden. In sicherheitskritischen Anwendungen wie der Wegplanung für Roboter in einer überfüllten Fabrikhalle reicht eine „fast richtige“ Antwort jedoch möglicherweise nicht aus. So könnte beispielsweise ein „fast richtiger“ Weg von einer Maschine zur anderen dennoch dazu führen, dass der Roboter mit einem menschlichen Kollegen kollidiert.
In solchen sicherheitskritischen Anwendungen greifen Anwender häufig auf eine Technik zurück, die als „projektionsbasiertes Sampling“ bezeichnet wird. Dabei werden die Teillösungen des Modells – sogenannte Zwischenwerte – während des Generierungsprozesses wiederholt so angepasst, dass sie strenge Anforderungen erfüllen.
Die Einschränkung des gesamten Generierungsprozesses kann jedoch dazu führen, dass das Modell keine bessere Endlösung erreicht. Diese Methoden konzentrieren sich in der Regel zudem ausschließlich auf die Erfüllung der harten Nebenbedingungen und lassen dabei die Möglichkeit außer Acht, andere Eigenschaften der Lösung zu verbessern, wie beispielsweise die Verkürzung der Bewegungsbahn des Roboters.
Stand: 08.12.2025
Es ist für uns eine Selbstverständlichkeit, dass wir verantwortungsvoll mit Ihren personenbezogenen Daten umgehen. Sofern wir personenbezogene Daten von Ihnen erheben, verarbeiten wir diese unter Beachtung der geltenden Datenschutzvorschriften. Detaillierte Informationen finden Sie in unserer Datenschutzerklärung.
Einwilligung in die Verwendung von Daten zu Werbezwecken
Ich bin damit einverstanden, dass die Vogel Communications Group GmbH & Co. KG, Max-Planckstr. 7-9, 97082 Würzburg einschließlich aller mit ihr im Sinne der §§ 15 ff. AktG verbundenen Unternehmen (im weiteren: Vogel Communications Group) meine E-Mail-Adresse für die Zusendung von redaktionellen Newslettern nutzt. Auflistungen der jeweils zugehörigen Unternehmen können hier abgerufen werden.
Der Newsletterinhalt erstreckt sich dabei auf Produkte und Dienstleistungen aller zuvor genannten Unternehmen, darunter beispielsweise Fachzeitschriften und Fachbücher, Veranstaltungen und Messen sowie veranstaltungsbezogene Produkte und Dienstleistungen, Print- und Digital-Mediaangebote und Services wie weitere (redaktionelle) Newsletter, Gewinnspiele, Lead-Kampagnen, Marktforschung im Online- und Offline-Bereich, fachspezifische Webportale und E-Learning-Angebote. Wenn auch meine persönliche Telefonnummer erhoben wurde, darf diese für die Unterbreitung von Angeboten der vorgenannten Produkte und Dienstleistungen der vorgenannten Unternehmen und Marktforschung genutzt werden.
Meine Einwilligung umfasst zudem die Verarbeitung meiner E-Mail-Adresse und Telefonnummer für den Datenabgleich zu Marketingzwecken mit ausgewählten Werbepartnern wie z.B. LinkedIN, Google und Meta. Hierfür darf die Vogel Communications Group die genannten Daten gehasht an Werbepartner übermitteln, die diese Daten dann nutzen, um feststellen zu können, ob ich ebenfalls Mitglied auf den besagten Werbepartnerportalen bin. Die Vogel Communications Group nutzt diese Funktion zu Zwecken des Retargeting (Upselling, Crossselling und Kundenbindung), der Generierung von sog. Lookalike Audiences zur Neukundengewinnung und als Ausschlussgrundlage für laufende Werbekampagnen. Weitere Informationen kann ich dem Abschnitt „Datenabgleich zu Marketingzwecken“ in der Datenschutzerklärung entnehmen.
Falls ich im Internet auf Portalen der Vogel Communications Group einschließlich deren mit ihr im Sinne der §§ 15 ff. AktG verbundenen Unternehmen geschützte Inhalte abrufe, muss ich mich mit weiteren Daten für den Zugang zu diesen Inhalten registrieren. Im Gegenzug für diesen gebührenlosen Zugang zu redaktionellen Inhalten dürfen meine Daten im Sinne dieser Einwilligung für die hier genannten Zwecke verwendet werden. Dies gilt nicht für den Datenabgleich zu Marketingzwecken.
Recht auf Widerruf
Mir ist bewusst, dass ich diese Einwilligung jederzeit für die Zukunft widerrufen kann. Durch meinen Widerruf wird die Rechtmäßigkeit der aufgrund meiner Einwilligung bis zum Widerruf erfolgten Verarbeitung nicht berührt. Um meinen Widerruf zu erklären, kann ich als eine Möglichkeit das unter https://contact.vogel.de abrufbare Kontaktformular nutzen. Sofern ich einzelne von mir abonnierte Newsletter nicht mehr erhalten möchte, kann ich darüber hinaus auch den am Ende eines Newsletters eingebundenen Abmeldelink anklicken. Weitere Informationen zu meinem Widerrufsrecht und dessen Ausübung sowie zu den Folgen meines Widerrufs finde ich in der Datenschutzerklärung, Abschnitt Redaktionelle Newsletter.
„Bei der Erfüllung von Nebenbedingungen kommt es letztendlich auf das Endergebnis des Modells an, da der interne Prozess außer Acht gelassen wird. Indem wir nicht verlangen, dass jeder Zwischenschritt die Nebenbedingungen erfüllt, geben wir dem Modell mehr Freiheit, qualitativ hochwertige Lösungen zu finden, die am Ende dennoch realisierbar sind“, sagt Zeyang Li, ein Doktorand im Fach Maschinenbau und LIDS sowie Co-Autor der begleitenden Studie. Die Forscher entwickelten einen Algorithmus namens „Hard Flow“, der den Stichprobenprozess so steuert, dass das Endergebnis die festen Vorgaben des Nutzers erfüllt, ohne dabei zu restriktiv zu sein, und gleichzeitig eine höhere Qualität aufweist.
Ein Feinsteuerungsmechanismus
Hard Flow formuliert die Sampling-Verfahren mit strengen Nebenbedingungen als Problem der Trajektorienoptimierung neu und nutzt dabei Werkzeuge aus dem Bereich der optimalen Steuerung. Dadurch kann das Framework die Sampling-Trajektorie des Modells auf ein Ziel hin lenken, dabei feine Korrekturen vornehmen und gleichzeitig strenge Nebenbedingungen für das Endergebnis durchsetzen. „Die Steuerungstheorie bietet uns ein leistungsstarkes Framework zur Formalisierung der optimalen Vorgehensweise bei diesen Korrekturen“, sagt Azizan.
Die Lösung des Problems der Trajektorienoptimierung für ein riesiges neuronales Netzwerk war jedoch keine leichte Aufgabe. Das Modell kann Hunderte miteinander verbundener Schichten umfassen, die Daten verarbeiten. Um das Problem lösbar zu machen, nutzten die Forscher die Struktur von Flow-Matching-Modellen, um das Problem in eine Abfolge kleinerer, einstufiger Teilprobleme zu zerlegen. Anschließend wandten sie systematische Transformationen und Approximationen an, um einen effizienten, skalierbaren Algorithmus abzuleiten, der dennoch eine realisierbare Lösung findet. „Im Wesentlichen haben wir das Problem der Trajektorienoptimierung so umformuliert, dass die wesentlichen Eigenschaften des ursprünglichen Problems erhalten bleiben, es sich aber zum Zeitpunkt der Bereitstellung sehr effizient lösen lässt“, erläutert Azizan.
Durch die Umformulierung der Aufgabe als Optimierungsproblem kann Hard Flow zusätzliche Ziele einbeziehen, die die Qualität des Endergebnisses verbessern können. So könnte Hard Flow beispielsweise einen kollisionsfreien Weg für einen Roboter finden, der gleichzeitig die kürzeste Strecke zum Ziel darstellt. „Unser Framework kann beide Aspekte gemeinsam berücksichtigen, wodurch es deutlich bessere Ergebnisse erzielt als bestehende Methoden“, sagt Li.
In Experimenten zu Robotermanipulation, Labyrinthnavigation und textgesteuerter Bildbearbeitung erreichte Hard Flow eine perfekte Erfüllung der Nebenbedingungen und übertraf dabei die Basismethoden hinsichtlich der Lösungsqualität durchweg. So ermöglichte es beispielsweise einem Robotermanipulator, Kollisionen mit Hindernissen zu vermeiden und gleichzeitig den schnellsten Weg zum Zielobjekt zu finden. Die meisten anderen Methoden führten entweder zu Kollisionen oder fanden Wege, die deutlich mehr Zeit in Anspruch nahmen. Zudem war die Rechenzeit von Hard Flow vergleichbar mit der der meisten konkurrierenden Methoden oder lag sogar darunter.
In Zukunft könnten die Forscher das Framework auf Szenarien ausweiten, in denen auch das KI-Modell selbst aktualisiert werden kann, sodass die Erfüllung der Nebenbedingungen und die Stichprobenqualität auf adaptivere Weise verbessert werden können. (sg)
*Originalveröffentlichung vom 14.9.2026 auf MIT News.