In Teil 1 unserer zweiteiligen Reihe zum Debugging von Echtzeitsystemen schilderten wir, welche Rolle Software-Tracing und Instrumentierung beim Debugging eines Embedded-RTOS spielen. In diesem Beitrag wird der konkrete Entwurf einer effizienten Trace-Infrastruktur für die Analyse von Systemprozessen erläutert.
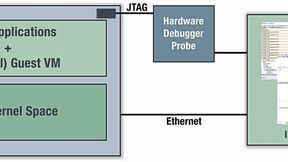
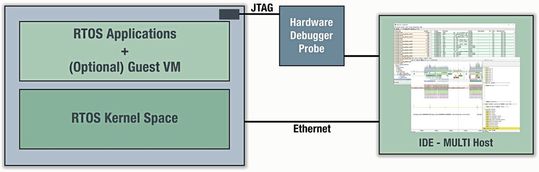
Bild 1: Erfassung und Übertragung von Trace-Daten vom eingebetteten Zielsystem zur Host-Analyseumgebung.
(Bild: GHS)
Software-Tracing kann Scheduling-Aktivitäten, die Ausführung von Interrupts, den Funktionsablauf und Ereignisse auf Anwendungsebene aufdecken, ohne ein laufendes eingebettetes System anzuhalten. Die Erzeugung dieser Ereignisse ist jedoch nur der Anfang. Um in einer Echtzeitumgebung eine nützliche Beobachtbarkeit zu gewährleisten, muss die Trace-Infrastruktur Daten erfassen, speichern, übertragen und interpretieren, ohne dabei einen unkontrollierten Ressourcenverbrauch zu verursachen oder das beobachtete System in unzumutbarer Weise zu beeinträchtigen.
Die Herausforderung beim Entwurf erstreckt sich vom Zielsystem bis zum Host. Pufferrichtlinien legen fest, welche Informationen bei erschöpftem Speicherplatz erhalten bleiben; Synchronisation und Zeitstempelung beeinflussen die Vorhersagbarkeit und den analytischen Wert; Plattformressourcen bestimmen die geeignete Trace-Strategie; und Übertragungsmechanismen müssen ein Gleichgewicht zwischen Vollständigkeit, Bandbreite und Determinismus herstellen. Virtualisierte und partitionierte Systeme stellen die zusätzliche Anforderung, Ereignisse über isolierte Domänen hinweg zu korrelieren.
Entwurf einer Trace-Infrastruktur für Echtzeitsysteme
Generierte Software-Trace-Ereignisse müssen zudem effizient erfasst und gespeichert werden.
In Echtzeitsystemen muss die Trace-Infrastruktur vorhersehbar arbeiten und nur eine begrenzte Menge an Ressourcen verbrauchen. Ringpuffer mit fester Größe werden häufig verwendet, da sie eine deterministische Speichernutzung und konstante Ausführungszeit gewährleisten.
Wenn der Puffer voll ist, kann das System je nach gewählter Strategie entweder ältere Einträge überschreiben oder neue Ereignisse verwerfen. Beide Ansätze sorgen für ein vorhersehbares Verhalten und verhindern ein unkontrolliertes Anwachsen des Speicherbedarfs, führen jedoch zwangsläufig zum Verlust von Trace-Informationen. Eine dritte Option besteht darin, den Pufferinhalt an den Host zu übertragen, sobald der Puffer voll ist, wodurch die gesammelten Trace-Daten erhalten bleiben. Wenn dieser Vorgang jedoch ein Anhalten oder Unterbrechen der Zielausführung erfordert, wird das normale Zeitverhalten des Systems verändert und der Echtzeit-Determinismus geht vorübergehend verloren. Die geeignete Strategie hängt daher davon ab, ob die Erhaltung vollständiger Trace-Informationen oder die Aufrechterhaltung einer ununterbrochenen deterministischen Ausführung höhere Priorität hat.
Ein weiterer wichtiger Aspekt bei der Konzeption ist die Synchronisation. Trace-Mechanismen sollten blockierende Operationen vermeiden, die die Task-Planung beeinträchtigen oder zu Prioritätsinversionsszenarien führen könnten. Oft werden leichtgewichtige und sperrfreie Implementierungen bevorzugt.
Auch die Zeitstempelung spielt eine entscheidende Rolle. Genaue Zeitstempel ermöglichen es Entwicklern, Ereignisabläufe zu rekonstruieren, Ausführungsdauern zu messen und Aktivitäten zu korrelieren, die über verschiedene Softwarekomponenten hinweg stattfinden. Ohne eine zuverlässige Zeitbasis verlieren Trace-Daten schnell einen Großteil ihres analytischen Werts.
Die optimale Trace-Strategie hängt stark von der Zielplattform ab. Geräte der Mikrocontroller-Klasse, die auf Arm-Cortex-M- und Cortex-R-Prozessoren basieren, arbeiten meist mit begrenzten Speicherressourcen und strengen zeitlichen Anforderungen. Trace-Puffer sind oft relativ klein, was die Menge der speicherbaren historischen Informationen einschränkt.
Daher müssen Entwickler sorgfältig auswählen, welche Ereignisse aufgezeichnet werden. Das Tracing jeder Funktion oder jedes Codeblocks kann mehr Daten erzeugen, als das System speichern oder übertragen kann. Eine selektive Instrumentierung ist daher unerlässlich.
Typische Trace-Ziele sind Scheduler-Ereignisse, Interrupt-Aktivitäten, Zustandsübergänge und kritische Zeitmessungen. Das Ziel besteht darin, die Transparenz zu maximieren und gleichzeitig das deterministische Systemverhalten zu bewahren.
Stand: 08.12.2025
Es ist für uns eine Selbstverständlichkeit, dass wir verantwortungsvoll mit Ihren personenbezogenen Daten umgehen. Sofern wir personenbezogene Daten von Ihnen erheben, verarbeiten wir diese unter Beachtung der geltenden Datenschutzvorschriften. Detaillierte Informationen finden Sie in unserer Datenschutzerklärung.
Einwilligung in die Verwendung von Daten zu Werbezwecken
Ich bin damit einverstanden, dass die Vogel Communications Group GmbH & Co. KG, Max-Planckstr. 7-9, 97082 Würzburg einschließlich aller mit ihr im Sinne der §§ 15 ff. AktG verbundenen Unternehmen (im weiteren: Vogel Communications Group) meine E-Mail-Adresse für die Zusendung von redaktionellen Newslettern nutzt. Auflistungen der jeweils zugehörigen Unternehmen können hier abgerufen werden.
Der Newsletterinhalt erstreckt sich dabei auf Produkte und Dienstleistungen aller zuvor genannten Unternehmen, darunter beispielsweise Fachzeitschriften und Fachbücher, Veranstaltungen und Messen sowie veranstaltungsbezogene Produkte und Dienstleistungen, Print- und Digital-Mediaangebote und Services wie weitere (redaktionelle) Newsletter, Gewinnspiele, Lead-Kampagnen, Marktforschung im Online- und Offline-Bereich, fachspezifische Webportale und E-Learning-Angebote. Wenn auch meine persönliche Telefonnummer erhoben wurde, darf diese für die Unterbreitung von Angeboten der vorgenannten Produkte und Dienstleistungen der vorgenannten Unternehmen und Marktforschung genutzt werden.
Meine Einwilligung umfasst zudem die Verarbeitung meiner E-Mail-Adresse und Telefonnummer für den Datenabgleich zu Marketingzwecken mit ausgewählten Werbepartnern wie z.B. LinkedIN, Google und Meta. Hierfür darf die Vogel Communications Group die genannten Daten gehasht an Werbepartner übermitteln, die diese Daten dann nutzen, um feststellen zu können, ob ich ebenfalls Mitglied auf den besagten Werbepartnerportalen bin. Die Vogel Communications Group nutzt diese Funktion zu Zwecken des Retargeting (Upselling, Crossselling und Kundenbindung), der Generierung von sog. Lookalike Audiences zur Neukundengewinnung und als Ausschlussgrundlage für laufende Werbekampagnen. Weitere Informationen kann ich dem Abschnitt „Datenabgleich zu Marketingzwecken“ in der Datenschutzerklärung entnehmen.
Falls ich im Internet auf Portalen der Vogel Communications Group einschließlich deren mit ihr im Sinne der §§ 15 ff. AktG verbundenen Unternehmen geschützte Inhalte abrufe, muss ich mich mit weiteren Daten für den Zugang zu diesen Inhalten registrieren. Im Gegenzug für diesen gebührenlosen Zugang zu redaktionellen Inhalten dürfen meine Daten im Sinne dieser Einwilligung für die hier genannten Zwecke verwendet werden. Dies gilt nicht für den Datenabgleich zu Marketingzwecken.
Recht auf Widerruf
Mir ist bewusst, dass ich diese Einwilligung jederzeit für die Zukunft widerrufen kann. Durch meinen Widerruf wird die Rechtmäßigkeit der aufgrund meiner Einwilligung bis zum Widerruf erfolgten Verarbeitung nicht berührt. Um meinen Widerruf zu erklären, kann ich als eine Möglichkeit das unter https://contact.vogel.de abrufbare Kontaktformular nutzen. Sofern ich einzelne von mir abonnierte Newsletter nicht mehr erhalten möchte, kann ich darüber hinaus auch den am Ende eines Newsletters eingebundenen Abmeldelink anklicken. Weitere Informationen zu meinem Widerrufsrecht und dessen Ausübung sowie zu den Folgen meines Widerrufs finde ich in der Datenschutzerklärung, Abschnitt Redaktionelle Newsletter.
Cortex-A-Plattformen weisen andere Einschränkungen auf. Diese Systeme bieten in der Regel deutlich mehr Speicher, eine höhere Rechenleistung und eine größere Kommunikationsbandbreite.
Größere Puffer ermöglichen längere Beobachtungsfenster und eine detailliertere Trace-Erfassung. Umfangreiche Betriebssystemumgebungen können zudem zusätzliche Diagnosefunktionen bieten und die Integration mit hostseitigen Analysewerkzeugen erleichtern.
Mehr Ressourcen bedeuten jedoch nicht, dass Disziplin nicht mehr erforderlich ist. Eine übermäßige Trace-Erzeugung kann zu einer überwältigenden Datenmenge führen und damit die Analyse erheblich erschweren. Selbst auf leistungsstarken Plattformen bleibt eine strukturierte Trace-Erfassung wichtig.
Abrufen von Trace-Daten vom Zielsystem
Bild 1: Erfassung und Übertragung von Trace-Daten vom eingebetteten Zielsystem zur Host-Analyseumgebung.
(Bild: GHS)
Das Erfassen von Trace-Informationen auf dem Zielsystem ist nur dann sinnvoll, wenn diese Informationen letztendlich analysiert werden können. Wie in Bild 1 dargestellt, werden Trace-Ereignisse vom RTOS-Kernel und von Anwendungen sowie optional von Gastdomänen generiert und in zielseitigen Trace-Puffern gespeichert. Die erfassten Daten können dann über eine Debug-Sonde oder eine andere verfügbare Kommunikationsschnittstelle extrahiert und an die Host-Entwicklungsumgebung übertragen werden. Dort werden die Trace-Informationen dekodiert und visualisiert, um die Task-Ausführung, die Scheduling-Aktivitäten, zeitliche Zusammenhänge und Ereignisse auf Anwendungsebene zu rekonstruieren.
Ein gängiger Ansatz ist die periodische Pufferauslesung. Trace-Daten werden im Speicher gesammelt und in vordefinierten Intervallen oder während kontrollierter Diagnosephasen an den Host übertragen. Diese Methode eignet sich gut für die Post-Run-Analyse und minimiert die Beeinträchtigung der Anwendungsausführung.
Ein weiterer Ansatz ist das kontinuierliche Streaming. Trace-Ereignisse werden bei ihrer Entstehung über Kommunikationskanäle wie Ethernet, serielle Schnittstellen oder Debug-Verbindungen an den Host weitergeleitet.
Das Streaming bietet Transparenz nahezu in Echtzeit, erfordert jedoch ein sorgfältiges Bandbreitenmanagement. Wenn die Trace-Übertragung zu viele Ressourcen beansprucht, kann dies das Verhalten der beobachteten Anwendung beeinträchtigen.
Aus diesem Grund trennen viele Systeme die Trace-Erzeugung von der Trace-Übertragung. Ereignisse werden zunächst lokal in einem Puffer gespeichert, während Hintergrundmechanismen die Kommunikation mit dem Host handhaben. Diese Trennung trägt dazu bei, den Determinismus zu wahren, und verhindert, dass Trace-Übertragungsvorgänge zeitkritische Ausführungswege beeinträchtigen.
Innovate Your Software – for a Smarter Future
Deutschlands Leitkongress der Embedded-Softwarebranche
Das Programm des ESE Kongress umfasst 96 Vorträge, 21 Seminare und 3 Keynotes. Seien Sie dabei, wenn sich die Embedded-Software-Community trifft, und nutzen Sie Diskussionen und Expertengespräche für einen ergiebigen Wissenstransfer und erfolgreiches Networken. Während der vier Kongresstage erwartet Sie zudem eine große Fachausstellung mit den führenden Firmen der Branche. Erfahren Sie alles über die neuesten Trends, Herausforderungen und Lösungen im Embedded Software Engineering, von KI, Safety und Security bis hin zu Management und Innovation.
Beobachtbarkeit in virtualisierten und partitionierten Systemen
Moderne eingebettete Architekturen stützen sich zunehmend auf Virtualisierungs- und Partitionierungstechnologien, um mehrere Softwareumgebungen auf einer einzigen Hardwareplattform zu konsolidieren.
Ein System kann gleichzeitig ein sicherheitskritisches RTOS, ein Gastbetriebssystem und zusätzliche Softwaredomänen beherbergen, die auf unterschiedlichen Kritikalitätsstufen laufen. Diese Architektur verbessert zwar Sicherheit, Schutz und Ressourcenauslastung, schafft aber auch neue Herausforderungen hinsichtlich der Beobachtbarkeit.
Jede Domäne arbeitet in ihrer eigenen isolierten Ausführungsumgebung. Ereignisse, die in einer Partition auftreten, sind für andere Partitionen in der Regel nicht sichtbar. Dadurch wird es erheblich schwieriger, die Wechselwirkungen im gesamten System nachzuvollziehen: Software-Tracing bietet hier eine praktische Lösung.
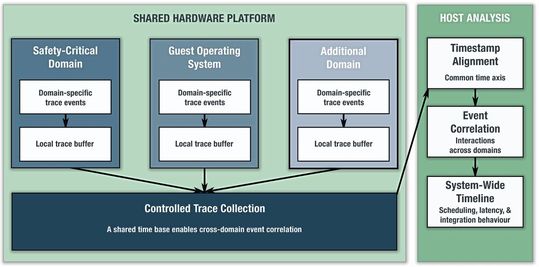
Bild 2: Domänenübergreifende Beobachtbarkeit in einem virtualisierten und partitionierten eingebetteten System.
(Bild: GHS)
Wie in Bild 2 ersichtlich, kann jede Domäne eigene Trace-Puffer verwalten und Informationen unabhängig sammeln. Die Trace-Daten können anschließend in eine gemeinsame Analyseumgebung exportiert werden, wo Zeitstempel abgeglichen und Ereignisse korreliert werden.
Dieser Ansatz bewahrt die Isolation und ermöglicht es Entwicklern gleichzeitig, das systemweite Verhalten zu rekonstruieren. So lässt sich nachvollziehen, wie Aktivitäten in einer Domäne das Verhalten in einer anderen beeinflussen, und es lassen sich Integrationsprobleme identifizieren, die allein durch domänenspezifisches Debugging nur schwer zu diagnostizieren wären.
Von Trace-Daten zu umsetzbaren Erkenntnissen
Das oberste Ziel der Ablaufverfolgung besteht nicht lediglich darin, Daten zu sammeln, sondern das Verständnis des Systems zu verbessern.
Visualisierungstools spielen in diesem Prozess eine entscheidende Rolle. Der MULTI History Viewer von Green Hills Software bietet beispielsweise eine zeitachsenbasierte Visualisierung der Systemausführung, die es Entwicklern ermöglicht, Systemereignisse, Task-Aktivitäten und das Ausführungsverhalten im Zeitverlauf miteinander in Beziehung zu setzen.
Aufgabenorientierte Ansichten helfen Ingenieuren dabei, sich auf das Verhalten einzelner Aufgaben oder Threads zu konzentrieren, während systemorientierte Ansichten einen umfassenderen Überblick über die CPU-Auslastung und die Scheduling-Muster bieten.
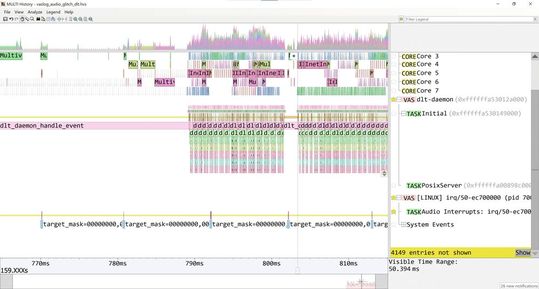
Bild 3: Zeitachsenbasierte Visualisierung der Multicore-Aufgabenausführung und von Systemereignissen anhand gesammelter Trace-Daten.
(Bild: GHS)
Bild 3 zeigt, wie gesammelte Trace-Daten in eine zeitachsenbasierte Darstellung des Systemverhaltens umgewandelt werden können. Ausführungsaktivitäten mehrerer Prozessorkerne, Tasks und Systemereignisse werden entlang einer gemeinsamen Zeitachse dargestellt, wodurch sich komplexe Interaktionen zur Laufzeit leichter analysieren lassen.
Durch die Korrelation der Aufgabenausführung mit Scheduling- und Systemereignissen können Entwickler Muster wie unerwartete Präemptionen, Ausführungsverzögerungen, übermäßige CPU-Aktivität oder ungewöhnliche Interaktionen zwischen Softwarekomponenten identifizieren.
Filter- und Zoomfunktionen helfen zudem dabei, bestimmte Ereignisse oder Zeitintervalle herauszufiltern, wodurch große Mengen an Trace-Daten in aussagekräftige Informationen für die Fehlersuche und Leistungsanalyse umgewandelt werden.
Durch die Beobachtung des Verhaltens über längere Ausführungszeiträume hinweg können Entwickler vereinzelte Anomalien von wiederkehrenden Designproblemen unterscheiden und fundierte Optimierungsentscheidungen treffen.
Da eingebettete Systeme immer komplexer werden, gewinnt die Beobachtbarkeit zur Laufzeit zunehmend an Bedeutung. Während Hardware-Tracing nach wie vor eine hervorragende Lösung darstellt, sofern verfügbar, erfordern praktische Einschränkungen oft alternative Ansätze.
Softwarebasiertes Tracing bietet eine flexible und skalierbare Möglichkeit, den Einblick in das Verhalten des Echtzeitbetriebssystems (RTOS) zu verbessern, ohne die normale Ausführung zu stören. Effiziente Pufferung, zuverlässige Zeitstempelung, plattformgerechte Erfassungsstrategien, kontrollierte Trace-Übertragung, domänenübergreifende Korrelation und effektive Visualisierung ermöglichen es Entwicklern, wertvolle Einblicke in Scheduling-Entscheidungen, zeitliche Zusammenhänge und das Anwendungsverhalten zu gewinnen.
Die Infrastruktur muss dennoch einen expliziten technischen Kompromiss widerspiegeln. Die Aufzeichnung jedes einzelnen Ereignisses kann Bandbreite oder Unterbrechungen des Zielsystems erfordern, während eine ununterbrochene, deterministische Ausführung möglicherweise die Akzeptanz einer unvollständigen Trace-Historie erfordert. Daher ist es unerlässlich, den Trace-Pfad vom Zielsystem zum Host entsprechend dem Diagnoseziel zu gestalten.
Anstatt herkömmliches Debugging oder Hardware-Tracing zu ersetzen, ergänzt das Software-Tracing beide Ansätze und hilft dabei, unsichtbare Laufzeitaktivitäten in aussagekräftiges technisches Wissen umzuwandeln. Bei modernen eingebetteten Systemen kann diese Transparenz den Unterschied ausmachen zwischen der vergeblichen Suche nach sporadisch auftretenden Problemen und deren Verständnis. (sg)
* Dr. Carmelo Loiacono ist ist Field Applications Engineer bei Green Hills Software.