Dedizierte Neural Processing Units werden in einer wachsenden Klasse von Microcontrollern zur eigenen Rechendomäne neben CPU und DSP. Ob sich ein konkretes KI-Modell mitsamt Eingaben, Aktivierungen, Vor- und Nachverarbeitung sowie der übrigen Firmware innerhalb des erreichbaren Speicher-, Latenz- und Energiebudgets ausführen lässt, verrät allerdings kein Datenblatt.
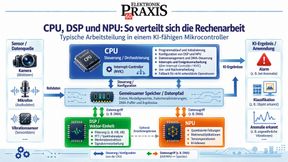
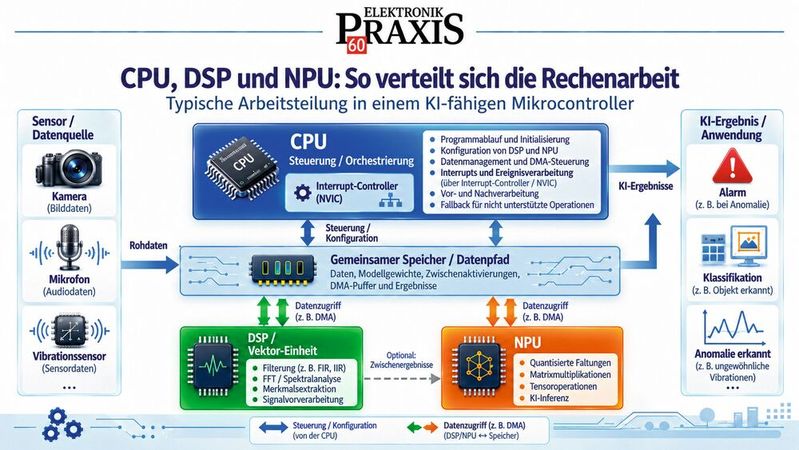
Schematische Arbeitsteilung in einem KI-fähigen Mikrocontroller: Die CPU steuert den Ablauf, DSP beziehungsweise Vektoreinheiten verarbeiten Signale, und die NPU beschleunigt unterstützte Tensoroperationen. Speicher und Datenpfade verbinden die Rechendomänen.
(Bild: Filipe Pereira Martins und Anna Kobylinska)
Die Arbeitsteilung innerhalb moderner Microcontroller verändert sich. Die CPU verschwindet nicht, ebenso wenig der DSP (Digital Signal Processor). Stattdessen kommt mit der Neural Processing Unit eine weitere spezialisierte Rechendomäne hinzu.
CPU und, sofern vorhanden, DSP bleiben für Steuerungslogik, Interruptbehandlung, Protokollstacks, Signalverarbeitung und nicht auf der NPU unterstützte Operationen zuständig. DSPs oder SIMD- beziehungsweise Vektorerweiterungen übernehmen beispielsweise Filter und Fourier-Transformationen. Die NPU beschleunigt dagegen vor allem regelmäßig strukturierte, quantisierte Tensoroperationen neuronaler Netze, etwa Faltungen und Matrixmultiplikationen.
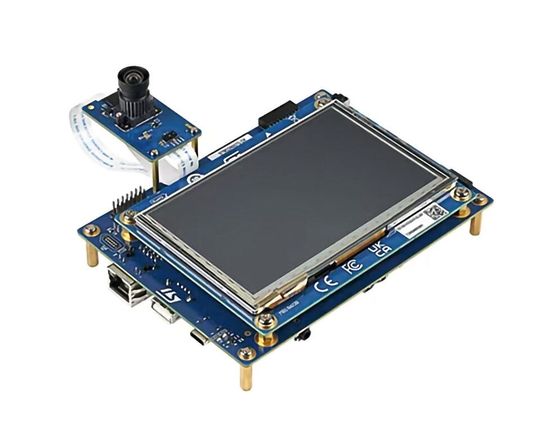
Das STM32N6570-DK bringt den STM32N6 mit Kamera, Display und externem Speicher auf eine Entwicklungsplattform. Der Microcontroller kombiniert einen Cortex-M55 mit STs Neural-ART-NPU. Insbesondere bei Vision-Anwendungen ist die Speicherarchitektur ebenso wichtig wie die reine Rechenleistung der NPU.
(Bild: ST Microelectronics)
Zwar können auch etwa Cortex-M-Kerne mithilfe von SIMD- oder Helium-Vektorerweiterungen neuronale Netze beschleunigen. Bei rechenintensiveren Modellen stößt die CPU jedoch zunehmend an Grenzen, weil sie die Tensoroperationen über ihren allgemeinen Befehls- und Datenpfad abarbeiten muss. NPUs verfügen dagegen über spezialisierte, parallel arbeitende Multiply-Accumulate-Einheiten und über Datenpfade, die auf die Wiederverwendung von Tensorwerten optimiert sind. Dadurch können sie insbesondere Faltungs- und Matrixoperationen mit einem geringeren Befehls- und Datenbewegungsaufwand ausführen.
Damit wird die NPU zu einem regulären Architekturbaustein einer wachsenden, aber keineswegs einheitlichen MCU-Klasse.
Der i.MX RT700 kombiniert zwei Cortex-M33-Kerne, Cadence-DSPs und die eIQ-Neutron-NPU. Die Chipdarstellung illustriert die Integration unterschiedlicher Rechendomänen in einer Crossover-MCU
(Bild: NXP)
Wie breit dieser Ansatz inzwischen geworden ist, zeigt das Produktspektrum. NXP kombiniert beim i.MX RT700 zwei Cortex-M33-Kerne, HiFi-4- und HiFi-1-DSP und die eigene eIQ-Neutron-NPU. ST setzt beim STM32N6 einen Cortex-M55 und die Neural-ART-NPU auf denselben Chip. Renesas verbindet im RA8P1 einen Cortex-M85, je nach Variante einen zusätzlichen Cortex-M33, und eine Ethos-U55-NPU. Infineon verfolgt beim PSOC Edge E84 eine Mehrdomänenarchitektur mit Cortex-M55 und Ethos-U55 in der High-Performance-Domäne sowie Cortex-M33 und NNLite-Beschleuniger im stromsparenden Always-on-Bereich.
Am anderen Ende des Spektrums steht Texas Instruments. Der MSPM0G5187 integriert TinyEngine bereits in eine Cortex-M0+-MCU mit 80 MHz, 128 KByte Flash und lediglich 32 KByte SRAM. Damit erreicht der NPU-Trend eine Leistungsklasse, in der bislang vor allem klassische TinyML-Verfahren auf der CPU üblich waren. TI spezifiziert für die NPU 2,56 GOPS und unterstützt 8-, 4- und 2-Bit-Gewichte sowie 8- und 4-Bit-Daten.
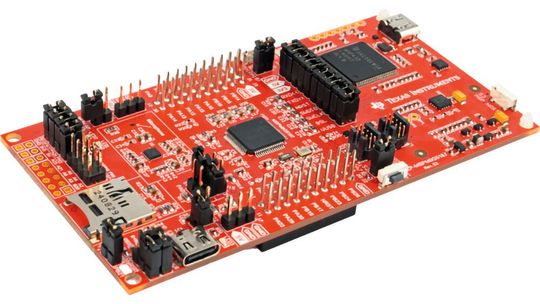
Mit dem MSPM0G5187 integriert Texas Instruments seine TinyEngine-NPU in einen Microcontroller mit Cortex-M0+-Kern. Damit rücken spezialisierte Beschleuniger auch in besonders energie- und kostensensitive MCU-Anwendungen vor – sie sind nicht länger leistungsstärkeren Microcontrollerklassen vorbehalten.
(Bild: Texas Instruments)
Die Produkte unterscheiden sich auch in ihrer Systemarchitektur. Während klassische MCUs wie TIs MSPM0G5187 Programmflash, SRAM und Peripherie mit vergleichsweise begrenzten Ressourcen integrieren, verbindet NXPs i.MX RT700 als Crossover-MCU mehrere CPU- und DSP-Kerne mit großem internem SRAM und einer NPU. Der STM32N6 kombiniert wiederum eine Cortex-M55-CPU mit leistungsfähiger Vision-Peripherie und Neural-ART-NPU, benötigt als Flashless-MCU aber externen nichtflüchtigen Programmspeicher. Noch weiter in Richtung Anwendungsprozessor reichen KI-SoCs mit Cortex-A-Kernen und DRAM-Anbindung, wie die später betrachtete Synaptics-SL2610-Familie.
Die NPU beginnt, sich über sehr unterschiedliche MCU-Klassen hinweg als eigener Architekturbaustein zu etablieren. Das Anwendungsspektrum reicht von kleinen Zeitreihenmodellen für Schwingungs- oder Stromsignale bis hin zur Bildverarbeitung, multimodalen Anwendungen und inzwischen auch sicherheitsgerichteten Automotive-MCUs.
Von einem universellen Standard kann dennoch keine Rede sein. Die KI-fähigen Microcontroller bilden bei Weitem keine einheitliche neue Produktklasse mit vergleichbaren Leistungskennzahlen. Sie sind vielmehr sehr unterschiedliche Antworten auf dieselbe Integrationsfrage: Wie viel Inferenzleistung lässt sich nahe am Sensor unter Echtzeit-, Energie- und Speicherzwängen unterbringen?
Stand: 08.12.2025
Es ist für uns eine Selbstverständlichkeit, dass wir verantwortungsvoll mit Ihren personenbezogenen Daten umgehen. Sofern wir personenbezogene Daten von Ihnen erheben, verarbeiten wir diese unter Beachtung der geltenden Datenschutzvorschriften. Detaillierte Informationen finden Sie in unserer Datenschutzerklärung.
Einwilligung in die Verwendung von Daten zu Werbezwecken
Ich bin damit einverstanden, dass die Vogel Communications Group GmbH & Co. KG, Max-Planckstr. 7-9, 97082 Würzburg einschließlich aller mit ihr im Sinne der §§ 15 ff. AktG verbundenen Unternehmen (im weiteren: Vogel Communications Group) meine E-Mail-Adresse für die Zusendung von redaktionellen Newslettern nutzt. Auflistungen der jeweils zugehörigen Unternehmen können hier abgerufen werden.
Der Newsletterinhalt erstreckt sich dabei auf Produkte und Dienstleistungen aller zuvor genannten Unternehmen, darunter beispielsweise Fachzeitschriften und Fachbücher, Veranstaltungen und Messen sowie veranstaltungsbezogene Produkte und Dienstleistungen, Print- und Digital-Mediaangebote und Services wie weitere (redaktionelle) Newsletter, Gewinnspiele, Lead-Kampagnen, Marktforschung im Online- und Offline-Bereich, fachspezifische Webportale und E-Learning-Angebote. Wenn auch meine persönliche Telefonnummer erhoben wurde, darf diese für die Unterbreitung von Angeboten der vorgenannten Produkte und Dienstleistungen der vorgenannten Unternehmen und Marktforschung genutzt werden.
Meine Einwilligung umfasst zudem die Verarbeitung meiner E-Mail-Adresse und Telefonnummer für den Datenabgleich zu Marketingzwecken mit ausgewählten Werbepartnern wie z.B. LinkedIN, Google und Meta. Hierfür darf die Vogel Communications Group die genannten Daten gehasht an Werbepartner übermitteln, die diese Daten dann nutzen, um feststellen zu können, ob ich ebenfalls Mitglied auf den besagten Werbepartnerportalen bin. Die Vogel Communications Group nutzt diese Funktion zu Zwecken des Retargeting (Upselling, Crossselling und Kundenbindung), der Generierung von sog. Lookalike Audiences zur Neukundengewinnung und als Ausschlussgrundlage für laufende Werbekampagnen. Weitere Informationen kann ich dem Abschnitt „Datenabgleich zu Marketingzwecken“ in der Datenschutzerklärung entnehmen.
Falls ich im Internet auf Portalen der Vogel Communications Group einschließlich deren mit ihr im Sinne der §§ 15 ff. AktG verbundenen Unternehmen geschützte Inhalte abrufe, muss ich mich mit weiteren Daten für den Zugang zu diesen Inhalten registrieren. Im Gegenzug für diesen gebührenlosen Zugang zu redaktionellen Inhalten dürfen meine Daten im Sinne dieser Einwilligung für die hier genannten Zwecke verwendet werden. Dies gilt nicht für den Datenabgleich zu Marketingzwecken.
Recht auf Widerruf
Mir ist bewusst, dass ich diese Einwilligung jederzeit für die Zukunft widerrufen kann. Durch meinen Widerruf wird die Rechtmäßigkeit der aufgrund meiner Einwilligung bis zum Widerruf erfolgten Verarbeitung nicht berührt. Um meinen Widerruf zu erklären, kann ich als eine Möglichkeit das unter https://contact.vogel.de abrufbare Kontaktformular nutzen. Sofern ich einzelne von mir abonnierte Newsletter nicht mehr erhalten möchte, kann ich darüber hinaus auch den am Ende eines Newsletters eingebundenen Abmeldelink anklicken. Weitere Informationen zu meinem Widerrufsrecht und dessen Ausübung sowie zu den Folgen meines Widerrufs finde ich in der Datenschutzerklärung, Abschnitt Redaktionelle Newsletter.
Ob eine konkrete KI-Anwendung auf einer bestimmten MCU funktioniert, entscheidet nicht allein die Rechenleistung des Beschleunigers. Die Gewichte eines quantisierten Modells können je nach Architektur in Flash, MRAM oder externem Speicher liegen. Während der Inferenz benötigen jedoch Eingaben, Zwischenaktivierungen, Tensor-Arena, DMA-Puffer sowie Vor- und Nachverarbeitung zusätzlichen Arbeitsspeicher. Bei manchen Architekturen müssen zudem Modelldaten für die NPU in erreichbaren SRAM übertragen werden. Auch Speicherbandbreite, Quantisierung, Operatorabdeckung und CPU-Fallbacks können die erreichbare Leistung beschränken.
Das Modell kompiliert, die NPU glänzt mit ihren Peak-Werten – und trotzdem scheitert die Anwendung.
Der erste Prototyp ist oft schnell aufgebaut: Sensor anschließen, KI-Modell quantisieren, Compiler starten, Demo auf das Evaluierungsboard flashen. Die NPU meldet hohe Auslastung, die Inferenzzeit sieht im Labor gut aus. Dann folgt die Integration: Die Kamera liefert größere Frames als die Demo, das RTOS beansprucht Speicher, die Kommunikationsschnittstelle benötigt DMA-Puffer, und einzelne Operatoren werden nicht mehr auf der NPU ausgeführt. Das Modell funktioniert weiterhin, aber es verfehlt Latenz-, Energie- oder Echtzeitanforderungen.
Der Haken an „172-mal schneller“
Wie problematisch isolierte Benchmarks sein können, zeigt die Markteinführung des i.MX RT700.
NXP erklärte bei der Vorstellung des i.MX RT700 im September 2024, die eIQ-Neutron-NPU beschleunige die Anomalieerkennung um bis zu Faktor 18 und die Bildklassifikation um bis zu Faktor 172 gegenüber der Ausführung auf dem Cortex-M33. Für den Energiebedarf je Inferenz nannte der Hersteller eine Reduktion um bis zu Faktor 119. Diese Spannweite verdeutlicht: Schon innerhalb derselben Plattform hängt der Beschleunigungsfaktor stark von der ausgeführten Aufgabe und vom Modell ab.
Wie stark die Beschleunigung vom jeweiligen Modell abhängt, zeigt eine später veröffentlichte NXP Application Note vom November 2025. Darin dokumentiert NXP für vier MLPerf-Tiny-Modelle Beschleunigungsfaktoren zwischen 17,5 und 169,1 gegenüber dem Cortex-M33. Die Messungen erfolgten bei 325 MHz mit dem MCUXpresso SDK 25.03.00. Die Werte sind im Übrigen Herstellermessungen, keine durch das MLCommons-Prüfverfahren bestätigten Ergebnisse. (Der interne Vergleich bleibt unter Vorbehalt konsistenter Testbedingungen aussagekräftig; Vergleiche mit anderen Herstellern brauchen zusätzliche Prüfung.)
Während das ResNet-Modell um Faktor 169,1 beschleunigt wurde, erreichte die Anomalieerkennung lediglich Faktor 17,5. Die nominelle NPU-Leistung erlaubt somit keine allgemeingültige Aussage über die tatsächliche Beschleunigung.
Bei unterstützten Faltungen und Matrixoperationen kann die NPU eine hohe Auslastung erreichen. Nicht unterstützte Operatoren, ungünstige Tensorformen oder nicht quantisierte Abschnitte verlagern dagegen Teile der Verarbeitung auf die CPU oder den DSP. Hinzu kommen Vorverarbeitung, Postprocessing und Datentransfers. Ohne Angaben zu Modellversion, Eingabeformat, Quantisierung, Taktfrequenzen, Speicherplatzierung, Compiler-Version, NPU-Abdeckung und Umfang der Zeitmessung bleiben Vergleiche nur eingeschränkt aussagekräftig.
Die „Memory Wall“
Für viele Edge-AI-Anwendungen beginnt die Dimensionierung nicht mit der Anzahl von GOPS laut Datenblatt, sondern mit der Frage „Wie viele Daten müssen während einer Inferenz gleichzeitig im erreichbaren Speicher liegen?“.
Die Modellgewichte bilden nur einen Teil des Speicherbedarfs. Während der Inferenz werden zusätzliche Bereiche für Eingaben, Zwischenaktivierungen, temporäre Berechnungen und die Laufzeitumgebung benötigt. Je nach Runtime verwaltet eine Tensor-Arena bereits mehrere dieser Bereiche. Hinzu kommen gegebenenfalls NPU-Kommandoströme sowie Arbeitsbereiche für CPU und DSP. Die Aktivierungen können gerade bei Faltungsnetzen den Speicherbedarf der Gewichte deutlich übersteigen.
Maßgeblich ist der höchste Speicherbedarf des kompilierten Graphen – also der Moment, in dem mehrere Datenblöcke gleichzeitig vorgehalten werden müssen. Das zeigt sich besonders deutlich in der Bildverarbeitung: Eingabebilder, Feature-Maps und weitere Zwischenpuffer können gleichzeitig Speicher belegen, während die Verarbeitungskette läuft.
Der i.MX RT700 besitzt laut NXP bis zu 7,5 MByte SRAM, doch die NPU kann unmittelbar nur auf 5,5 MByte davon zugreifen. In einer NXP-Anwendung zur Objekterkennung bleibt deshalb das vollständige RGB-Kamerabild im externen PSRAM. Erst das auf 320 × 320 Pixel skalierte Eingabebild wird für die NPU in internen SRAM kopiert. Das Beispiel zeigt, dass Gesamtspeicher und NPU-erreichbarer Speicher nicht dasselbe sind.
Der STM32N6 verfolgt einen anderen Ansatz. ST integriert 4,2 MByte zusammenhängenden internen RAM und kombiniert ihn mit der Neural-ART-NPU und schnellen Schnittstellen für externen Speicher. Die Architektur ist darauf ausgelegt, größere Datenströme aus Kamera-, Audio- und Sensorschnittstellen möglichst effizient zum Beschleuniger zu bringen.
Die Neural-ART-NPU verfügt über Streaming-Einheiten, eine Gewichtsdekompression und eigene Speicherpfade. Ihre Leistung hängt dennoch maßgeblich davon ab, wo Gewichte, Aktivierungen und Arbeitsbereiche im Speicher liegen. Der Compiler optimiert deren Platzierung anhand der konfigurierten Speicherpools und ihrer Zugriffseigenschaften. Analyse- und Profilingwerkzeuge zeigen die Speicherbelegung und das Laufzeitverhalten. Damit lässt sich feststellen, ob die Rechenleistung der NPU oder der Datennachschub die Ausführung eines Modells begrenzt.
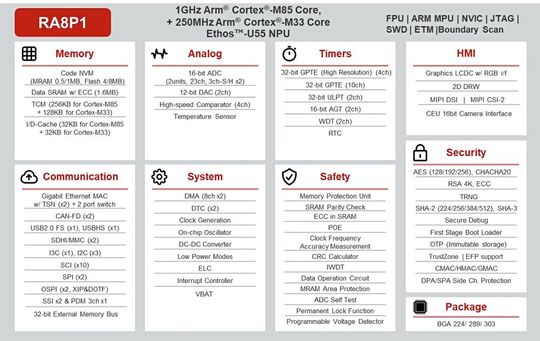
Auch Renesas kombiniert beim RA8P1 verschiedene Speichertechnologien, um Modellgewichte und Laufzeitdaten unterzubringen. Der Mikrocontroller verfügt über insgesamt 2 MByte SRAM einschließlich TCM-Speicher und je nach Variante über 0,5 oder 1 MByte MRAM. Zusätzlich stehen SiP-Ausführungen mit 1 MByte MRAM und 4 beziehungsweise 8 MByte Flash zur Verfügung. Externe Speicher lassen sich ebenfalls anbinden.
Das Blockdiagramm des RA8P1 zeigt die Kombination aus Cortex-M85, Cortex-M33 und Ethos-U55-NPU sowie die zugehörigen Speicher- und Peripherieblöcke.
(Bild: Renesas)
Der MSPM0G5187 zeigt dagegen, wie weit sich eine NPU nach unten skalieren lässt – und wo die Grenzen liegen. 32 KByte SRAM erzwingen kleine Eingabefenster, kompakte Aktivierungstensoren und entsprechend zugeschnittene neuronale Netze. Ein Vision-Modell, dessen Laufzeitumgebung mehrere Megabyte Arbeitsspeicher voraussetzt, wird nicht allein dadurch MCU-tauglich, dass die NPU theoretisch genügend Rechenoperationen ausführen könnte.
Die Speicherarchitektur setzt eine der entscheidenden Grenzen für die Modellwahl. Ob ein Modell im realen System sinnvoll ausführbar ist, bestimmen jedoch ebenso Operatorabdeckung, Datenbewegung, Latenz und Energiebedarf.
Externer Speicher erweitert die Auswahl ausführbarer Modelle, kann jedoch zusätzliche Off-Chip-Transfers verursachen und dadurch Latenz und Energiebedarf erhöhen. Wie stark diese Effekte ausfallen, hängt von Speicherbandbreite, Zugriffsmustern, Caching und DMA-Nutzung ab.
Für eine Vorauswahl reicht daher die SRAM-Gesamtzahl im Datenblatt nicht. Benötigt werden der Peak-Bedarf des kompilierten Netzes, die erreichbaren Speicherbänke, deren parallele Nutzbarkeit, die Bandbreite zum Beschleuniger und die Reserven für RTOS, Kommunikation und Anwendungscode.
Quantisierung von Anfang an mitdenken
Eine naheliegende Gegenmaßnahme gegen knappen Speicher stellt Quantisierung dar. Indem sie Gewichte und häufig auch Aktivierungen von Gleitkommaformaten auf kleinere Ganzzahlformate reduziert, beeinflusst sie nicht nur die Modellgröße, sondern auch Speicherbandbreite, Datenbewegung und den auf der NPU nutzbaren Rechenpfad.
Bei NPU-beschleunigter Inferenz auf Microcontrollern ist INT8 der verbreitete Ausgangspunkt. Vier 8-Bit-Werte benötigen nominell nur so viel Speicher wie ein einzelner 32-Bit-Gleitkommawert. Die tatsächliche Größe des kompilierten Modells hängt jedoch auch von Metadaten, Alignment und gegebenenfalls umformatierten Gewichten ab. Entscheidend ist zudem, ob die Ziel-NPU die betreffenden Operatoren und Quantisierungsschemata nativ unterstützt.
ST empfiehlt für Neural-ART vollständig quantisierte INT8-Modelle. Teilweise quantisierte Netze werden zwar akzeptiert, ihre Gleitkommaabschnitte laufen jedoch als Software- oder Hybrid-Epochen auf dem Cortex-M55. In der aktuellen Validierungsdokumentation weist ST ausdrücklich darauf hin, dass auf die CPU zurückfallende Operatoren ein bis zwei Größenordnungen langsamer als die NPU-Ausführung sein können.
Quantisierung verändert, wie das Modell seine Daten speichert und verarbeitet.
Arm legt Ethos-U primär für INT8-Gewichte sowie INT8- beziehungsweise INT16-Aktivierungen aus. Diese Architektur findet sich unter anderem in Renesas RA8P1, Infineon PSOC Edge sowie in verschiedenen Synaptics-MCUs.
TI geht beim MSPM0G5187 weiter und spezifiziert 8-, 4- und 2-Bit-Gewichte sowie 8- und 4-Bit-Daten. Ob daraus tatsächlich ein kleineres und schnelleres Modell entsteht, hängt jedoch davon ab, welche Netzstrukturen und Datentypen der Compiler durchgängig auf der NPU abbilden kann. Kanalzahlen, Kernelgeometrien, Compilerregeln und Genauigkeitsverluste begrenzen die nutzbaren Konfigurationen.
Sobald einzelne Operatoren nicht in der gewünschten Präzision unterstützt werden, kann der Vorteil teilweise verloren gehen. Der Compiler muss den Graphen anders partitionieren, Daten umformatieren oder Abschnitte auf CPU beziehungsweise DSP ausführen.
Auch die Modellgenauigkeit setzt klare Grenzen. INT8 ist für viele Anwendungen inzwischen gut beherrschbar. Bei INT4 oder noch geringeren Bitbreiten steigen dagegen die Anforderungen an Training und Kalibrierung. Quantization-aware Training kann notwendig werden, um Erkennungsrate oder Fehlalarmquote innerhalb der Systemanforderungen zu halten.
Wer eine MCU-NPU effizient nutzen will, sollte das neuronale Netz von Anfang an auf die Zielhardware abstimmen, statt erst beim Export eines fertigen GPU-Modells anzusetzen. Kleinere Eingaben, weniger Kanäle, Pruning und Quantization-aware Training können den Ressourcenbedarf frühzeitig senken. Auch Depthwise-Separable Convolutions kommen infrage, sofern die Ziel-NPU sie effizient unterstützt. Solche Anpassungen können mehr bewirken als die nachträgliche Konvertierung eines Modells, das ursprünglich für eine GPU oder die Cloud entwickelt wurde.
Eine kurze Laufzeit nützt wenig, wenn die Quantisierung die Erkennungsleistung oder Robustheit unter das geforderte Niveau senkt. Der Abgleich des kompilierten Modells mit der quantisierten Referenz reicht dafür nicht aus: Er prüft die Übereinstimmung beider Fassungen, nicht den Erhalt der ursprünglichen Modellgüte. Ob diese erhalten bleibt, muss ein Vergleich mit dem Ausgangsmodell anhand repräsentativer Validierungsdaten zeigen.
Warum die CPU bleibt
Die NPU ist ein Executor für einen begrenzten Satz von Tensoroperatoren, kein Ersatz für einen universellen Prozessor. Sensoraufnahme, Normalisierung, Bildskalierung, Feature-Aufbereitung, Ergebnisfilterung, Non-Maximum Suppression (NMS), Kommunikation und Zustandsautomaten bleiben typischerweise bei CPU, DSP oder dedizierten Peripherieblöcken. Auch nicht unterstützte Operatoren benötigen einen anderen Ausführungspfad.
Beim RA8P1 werden nicht auf Ethos-U55 abbildbare Operatoren auf dem Cortex-M85 ausgeführt; unterstützte CPU-Kernel können dabei unter anderem über CMSIS-NN beschleunigt werden. Das RUHMI-Framework („Robust Unified Heterogenous Model Integration“) von Renesas übernimmt Modelloptimierung, Quantisierung und Graph-Partitionierung und hilft bei der Zuordnung der benötigten Speicherbereiche.
Selbst wenn die NPU sämtliche Tensoroperationen übernimmt, kann die CPU weiterhin für Initialisierung, Ablaufsteuerung und Synchronisation benötigt werden. Zusätzlicher Aufwand entsteht dann, wenn CPU oder DSP nicht unterstützte Operatoren ausführen müssen. Der Wechsel zwischen den Recheneinheiten kann Tensorumformatierungen, Cache-Wartung oder Datentransfers zwischen Speicherbereichen erfordern. Ein hoher NPU-Anteil am Modellgraphen garantiert daher noch keine kurze **Inferenzzeit**: Müssen CPU und NPU häufig aufeinander warten oder Tensoren für die Übergabe umformatieren und verschieben, kann dieser Aufwand den Zeitgewinn durch die NPU schmälern.
Wann reicht die NPU-MCU?
Ob eine NPU-fähige MCU ausreicht, hängt zunächst davon ab, ob das quantisierte Zielmodell einschließlich aller benötigten Puffer in den erreichbaren Speicher passt und ob sich seine Operatoren auf die verfügbaren Recheneinheiten abbilden lassen. Damit ist die Anwendung jedoch noch nicht für den praktischen Einsatz qualifiziert.
Für die Praxis entscheidend ist vielmehr, ob die vollständige Verarbeitungskette vom Eingangspuffer bis zum verwertbaren Ergebnis auf dem Zielboard die geforderten Latenz-, Energie- und Qualitätsziele erreicht. Hinzu kommen die Bereitstellung ausreichender Reserven für RTOS, Kommunikation und Anwendung sowie einer Toolchain, mit der sich Speicherzugriffe, CPU-Fallbacks und Regressionsfehler reproduzierbar untersuchen lassen.
Wie unterschiedlich die Hersteller diese Anforderungen adressieren, zeigt Infineons PSOC Edge E84. Dessen NNLite-Beschleuniger ist für vergleichsweise einfache Always-on-Aufgaben wie Schlüsselwort- oder Aktivitätserkennung ausgelegt. Sie lassen sich in der stromsparenden Cortex-M33-Domäne ausführen, ohne dafür ständig die leistungsfähigere Cortex-M55/Ethos-U55-Domäne zu benötigen. Für die Energiebilanz kommt es damit auch darauf an, wie häufig die High-Performance-Domäne aktiviert werden muss und welcher Aufwand beim Datenaustausch entsteht.
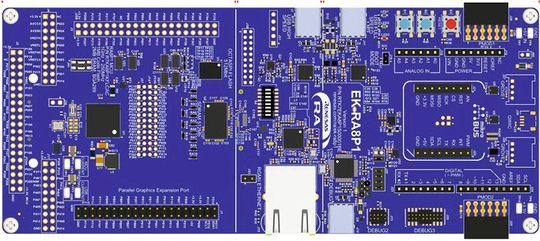
Der RA8P1 von Renesas verbindet einen Cortex-M85 mit Cortex-M33 und Arm Ethos-U55. Das EK-RA8P1 dient als Entwicklungsplattform für KI-, Vision- und IoT-Anwendungen und zeigt exemplarisch, wie die NPU als zusätzliche Rechendomäne in eine MCU-Architektur einzieht.
(Bild: Renesas)
Renesas setzt beim RA8P1 auf eine andere Gewichtung. Eine Referenzanwendung mit MobileNet V1 0.25 benötigt auf der Ethos-U55-NPU nur etwa 1 bis 2 ms für die Inferenz. Die Kamera liefert 55 Bilder/s, das Display gibt 29 Bilder/s aus. Diese Werte gelten auch für die CPU-basierte Vergleichskonfiguration und beschreiben nicht den tatsächlichen KI-Klassifikationsdurchsatz. Die Renesas-Messungen zeigen außerdem, dass CPU-Inferenz erheblich vom Datencache profitiert, während die NPU über DMA- beziehungsweise AXI-Zugriffe stärker von der Speicherbandbreite abhängt. Für die Systemleistung sind folglich nicht allein die NPU-Laufzeit, sondern auch Speicherzugriffe und die übrige Verarbeitungskette entscheidend.
Beim STM32N6 von ST rückt dagegen die Bildvorverarbeitung in den Vordergrund. Die integrierte Kamerapipeline DCMIPP kann Bildausschnitte auswählen, die Auflösung reduzieren und Farbraumkonvertierungen vornehmen, bevor die Daten an die Inferenz übergeben werden. Dadurch lassen sich Teile der Vorverarbeitung von der CPU in spezialisierte Hardware verlagern. Für Vision-Anwendungen ist somit auch entscheidend, wie effizient Kamera, Bildverarbeitung, Speicher und NPU zusammenarbeiten.
Ein externer KI-Beschleuniger ist sinnvoll, wenn die vorhandene MCU für Echtzeitsteuerung oder Zertifizierung gesetzt ist, die Inferenz aber ihre Rechen- oder Speichergrenzen überschreitet. Die Trennung kann unterschiedliche Entwicklungs- und Updatezyklen ermöglichen. Sie kostet jedoch zusätzliche Bauteile, Platinenfläche, Stromversorgungen, Treiber und Schnittstellenbandbreite. Besonders bei Kameraanwendungen muss geprüft werden, ob das Verschieben großer Frames den Effizienzgewinn des Beschleunigers teilweise wieder aufzehrt.
Ein KI-SoC oder eine MPU ist angemessener, wenn Linux, großer DRAM, mehrere hochauflösende Kameras, häufig wechselnde Modelle, komplexe Frameworks oder größere Transformer benötigt werden. Arm ordnet Cortex-M-Systeme vor allem kosten- und energiebegrenzten Aufgaben zu, während Cortex-A-Plattformen reichhaltige Betriebssysteme und flexiblere Speichersysteme adressieren.
Ein Beispiel ist die SL2610-Familie von Synaptics. Je nach Ausführung kombiniert sie einen oder zwei Cortex-A55-Kerne mit DDR-Anbindung, NPU und Cortex-M52 für das Systemmanagement. So integriert der SL2619 sämtliche genannten Recheneinheiten, während der einfachere SL2611 ohne NPU auskommt. Trotz des zusätzlichen Mikrocontrollerkerns handelt es sich um einen KI-SoC und nicht um eine klassische MCU.
Acht Prüfungen vor dem Design-in
Ob eine NPU-fähige MCU für die betreffende Anwendung ausreicht, zeigt sich erst im Zusammenspiel des KI-Modells mit dem Datenpfad und dem Betriebsprofil. Diese acht Punkte sollten vor dem Design-in geklärt sein:
Modell festlegen: Welche Modellversion, Eingabegröße und Zielgüte liegen der Messung zugrunde?
Spitzenbedarf im Speicher bestimmen: Wie viel Speicher benötigen Gewichte, Aktivierungen, Tensor-Arena, Ein- und Ausgabepuffer sowie die Anwendung gleichzeitig?
Speicherzugriff prüfen: Auf welche SRAM-Bänke, Flash-Bereiche und externen Speicher kann die NPU tatsächlich zugreifen?
Abdeckung des Modellgraphen messen: Welche Operatoren führt die NPU aus, welche übernimmt CPU oder DSP?
Datenbewegung erfassen: Wie viele Bytes wandern pro Inferenz zwischen Sensor, SRAM, externem Speicher und den einzelnen Rechendomänen?
End-to-End-Latenz messen: Berücksichtigt die Messung Vorverarbeitung, Inferenz, mögliche Fallbacks und Nachverarbeitung?
Energieverbrauch reproduzierbar messen: Sind Spannung, Taktfrequenzen, Speicherbelegung, Board, Messpunkt und Duty Cycle dokumentiert?
Toolchain absichern: Lassen sich Compiler-, Runtime- und Modellversionen fixieren, debuggen und über den Produktlebenszyklus hinweg warten?
Wohin sich die NPU-MCU entwickelt
Die Integration von NPUs erweitert sich zunehmend auf Mikrocontroller für drahtlose Kommunikation, Echtzeitregelung und sicherheitskritische Steuerungsaufgaben. Dabei entstehen neue Anforderungen an die Abstimmung zwischen KI-Beschleuniger und den übrigen Funktionsblöcken.
Synaptics kombiniert beim SRW1500 einen Cortex-M52, eine Ethos-U55-NPU mit 50 GOPS, 1 MByte SRAM und Wi-Fi 7 auf einem Chip. Die Plattform kann damit Sensordaten lokal auswerten und die Ergebnisse über die integrierte Funkanbindung bereitstellen. Für die Systemauslegung stellt sich die Frage, welche Daten lokal verarbeitet werden und welche übertragen werden müssen. Denn auch bei integrierter Konnektivität können Funkaktivität und Datenverkehr die Energiebilanz wesentlich beeinflussen. Die Serienproduktion ist nach Herstellerplanung für das vierte Quartal 2026 vorgesehen.
Texas Instruments verbindet beim AM13E230x KI-Beschleunigung unmittelbar mit der Echtzeitregelung. Der bislang als Preview verfügbare Mikrocontroller integriert neben dem Cortex-M33 und der TinyEngine-NPU eine Trigonometric Math Unit für rechenintensive Regelungsalgorithmen. Während die NPU beispielsweise Zeitreihen aus Strom- oder Schwingungsmessungen klassifizieren kann, übernimmt die TMU trigonometrische Berechnungen für die Motorregelung. Die Herausforderung besteht darin, die KI-Auswertung neben zeitkritischen Regelungsaufgaben auszuführen, ohne deren Worst-Case-Latenz zu verletzen.
ST überträgt den Ansatz mit dem Stellar P3E auf Automotive-Steuergeräte. Die auf Cortex-R52+ basierende MCU verbindet eine Neural-ART-NPU mit einer Split-Lock-Architektur, die unterschiedliche Betriebsarten für hohe Rechenleistung und funktionale Sicherheit ermöglicht. Für die Integration von KI in sicherheitskritische Steuerungen reicht die NPU-Leistung allein deshalb nicht aus: Auch die zeitliche und räumliche Trennung von KI- und Steuerungsaufgaben muss berücksichtigt werden. Der Produktionsbeginn ist nach Herstellerangaben für das vierte Quartal 2026 geplant.
Fazit
Die reine NPU-Leistung im Datenblatt sagt noch wenig darüber aus, ob sich eine konkrete Plattform für ein bestimmtes KI-Modell eignet. Ob ein Modell unter realen Bedingungen läuft, hängt selten allein von der GOPS-Zahl ab. Wie viel KI in eine MCU passt, zeigt sich vielmehr im Zusammenspiel von Modellarchitektur, verfügbarem Speicher, Datenpfaden zwischen den Rechendomänen, der Abdeckung des Rechengraphen durch die NPU, dem Energiebedarf sowie dem Aufwand für Optimierung, Integration und Debugging in der Toolchain. (sg)
* Anna Kobylinska und Filipe Pereia Martins arbeiten für McKinley Denali, Inc., USA.